ИТ-мониторинг и observability: как быстрее находить проблемы в ИТ-системах
Современный ИТ-мониторинг помогает не только обнаруживать сбои, но и быстро находить их причины
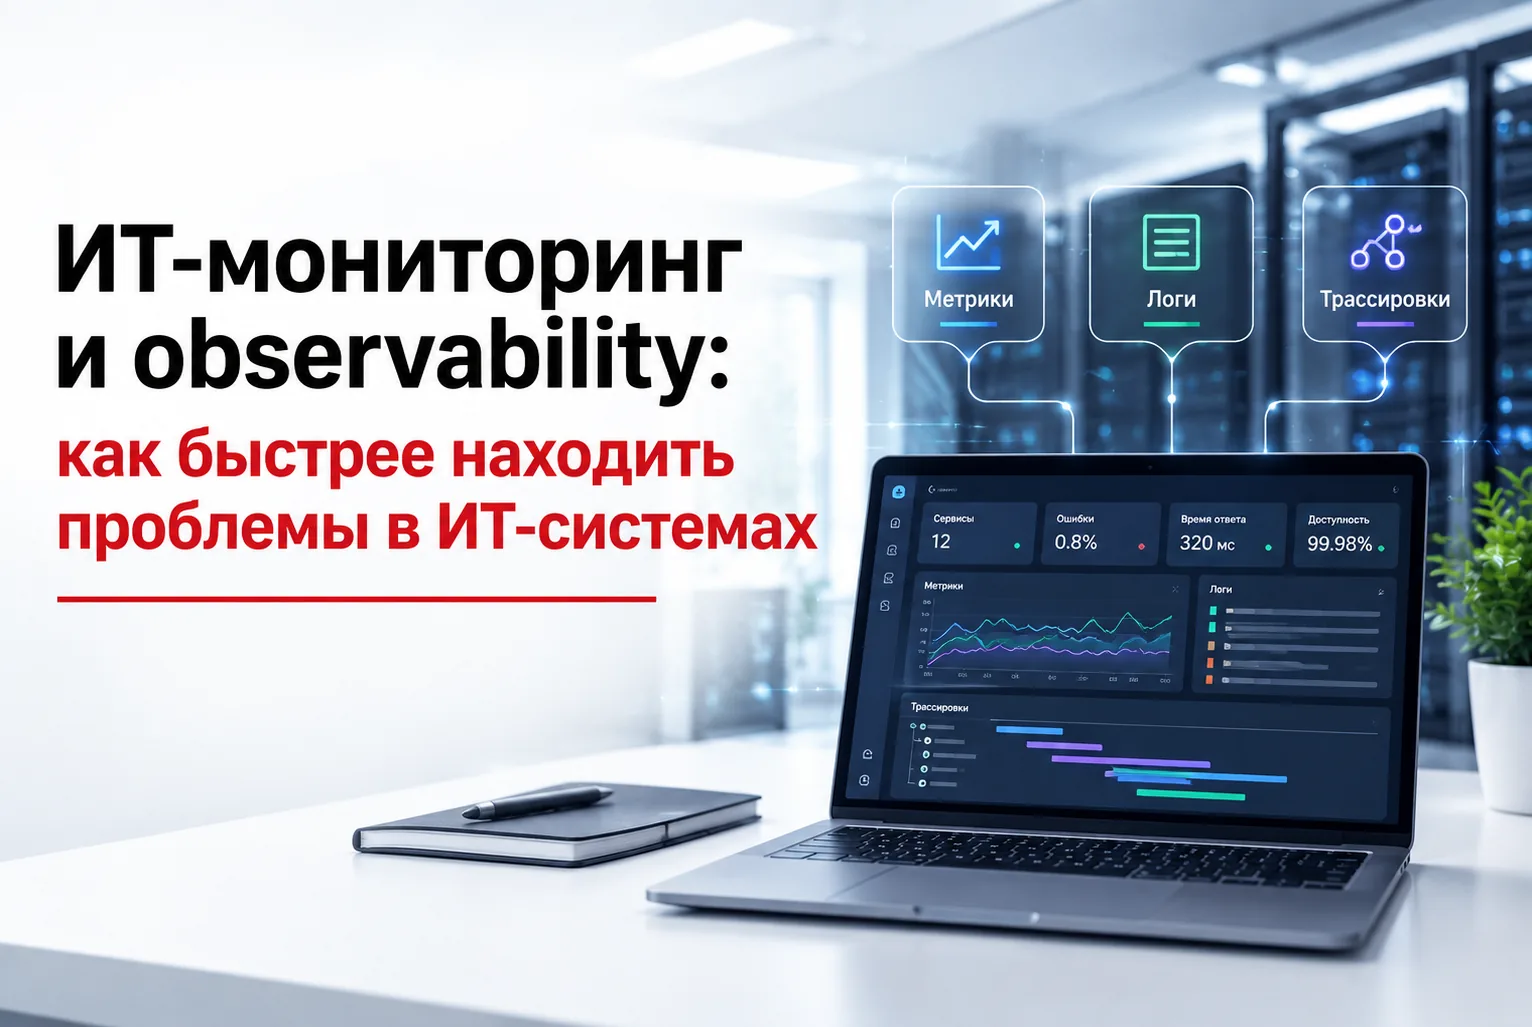
Современный ИТ-мониторинг помогает не просто узнать о сбое, а быстро понять, что произошло, где возникла проблема и как её устранить. Это сокращает время простоя сервисов, снижает нагрузку на ИТ-команду и помогает избежать ситуаций, когда небольшая техническая ошибка приводит к серьёзным потерям для бизнеса.
Именно поэтому всё больше компаний переходят от обычного мониторинга к observability (наблюдаемости). Такой подход объединяет метрики, логи и трассировки и даёт специалистам полную картину происходящего внутри ИТ-системы.
01Что такое observability простыми словами
Обычный мониторинг может сообщить: «Сервис работает медленно» или «Сервер недоступен». Но для специалиста этого недостаточно. Нужно понять причину: проблема с сервером, базой данных, сетью или конкретным сервисом?
Observability помогает ответить на этот вопрос.
Для этого система собирает три основных вида информации:
- метрики показывают состояние системы в цифрах;
- логи рассказывают, какие события и ошибки произошли;
- трассировки показывают путь конкретного запроса через разные сервисы.
Представим интернет-магазин. Пользователь нажимает кнопку «Оформить заказ», но страница загружается 10 секунд. Метрика покажет рост времени ответа. Лог может показать ошибку при обращении к базе данных. А трассировка поможет увидеть, что именно запрос к базе занял большую часть времени.
В результате специалисту не приходится проверять каждый компонент системы вручную.
02Метрики: что происходит с системой
Метрики мониторинга — это числовые показатели, которые помогают следить за состоянием инфраструктуры и приложений. Их удобно отображать на графиках и использовать для автоматических уведомлений.
Обычно мониторят три группы показателей.
Инфраструктурные метрики
Они показывают состояние серверов и оборудования:
- загрузку процессора (CPU);
- использование оперативной памяти (RAM);
- свободное место на диске;
- сетевой трафик;
- доступность серверов;
- время бесперебойной работы.
Например, если сервер постоянно работает на 95–100% CPU, это может быть сигналом о повышенной нагрузке или проблеме с приложением.
Метрики приложений
Они помогают понять, насколько хорошо работает сам сервис:
- количество запросов в секунду (RPS);
- время ответа (latency);
- процент ошибок;
- длина очередей;
- количество активных соединений;
- загрузка пулов соединений.
Такие показатели позволяют обнаружить проблему ещё до того, как пользователи массово начнут жаловаться.
Бизнес-метрики
ИТ-мониторинг можно связать и с показателями бизнеса. Например, отслеживать количество активных пользователей, конверсию, оформление заказов или добавление товаров в корзину.
Это позволяет увидеть связь между техническими проблемами и бизнес-результатами.
Чем собирают метрики
Одним из самых популярных инструментов является Prometheus. Он особенно широко используется в контейнерных средах и хорошо работает вместе с Grafana.
Также применяют Telegraf, а для сбора данных о серверах и контейнерах — Node Exporter и cAdvisor.
При настройке мониторинга важно не собирать абсолютно всё подряд. Слишком большое количество уникальных параметров увеличивает объём данных и усложняет работу системы.
03Логи: что именно произошло
Если метрики отвечают на вопрос «что происходит?», то логи помогают разобраться «что именно произошло?».
Например, мониторинг зафиксировал увеличение количества ошибок. В логах можно найти конкретное сообщение об ошибке, время её возникновения и сервис, в котором она появилась.
Сегодня всё чаще используют структурированные логи, например в формате JSON. Вместо длинного текста каждое событие содержит отдельные поля: название сервиса, окружение, уровень ошибки, идентификатор запроса и другие данные.
Это значительно упрощает поиск.
Для хранения и анализа логов используются:
- Loki — хорошо подходит для работы вместе с Grafana;
- Elasticsearch / OpenSearch — удобны для поиска и анализа большого количества логов;
- Fluent Bit / Fluentd — используются для сбора и передачи логов.
Главное преимущество централизованных логов — специалисту не нужно подключаться к каждому серверу отдельно, чтобы искать причину ошибки.
04Трассировки: где именно возникла проблема
В современных системах один пользовательский запрос может проходить через несколько сервисов.
Например:
сайт → API → сервис заказов → база данных → платёжный сервис.
Если заказ обрабатывается слишком долго, определить причину только по общей метрике бывает сложно.
Трассировка показывает весь путь запроса и время, которое он провёл на каждом этапе.
Здесь используются три основных понятия:
- Trace — полный путь одного запроса;
- Span — отдельная операция внутри этого пути;
- Trace ID — уникальный идентификатор, который помогает найти связанные данные.
Например, трассировка может показать, что из 5 секунд обработки заказа 4 секунды занял запрос к базе данных. Это сразу сужает область поиска.
05OpenTelemetry: как объединить данные
Для сбора метрик, логов и трассировок всё чаще используется OpenTelemetry.
Его можно представить как единый стандарт, который помогает приложениям передавать данные о своей работе в системы мониторинга.
Часто схема выглядит так:
- приложение собирает данные с помощью OpenTelemetry;
- OpenTelemetry Collector принимает и обрабатывает информацию;
- метрики передаются в Prometheus;
- логи — в Loki или Elasticsearch;
- трассировки — в Jaeger или Tempo;
- Grafana объединяет информацию на удобных дашбордах.
В результате ИТ-специалист может работать с разными источниками данных практически из одного интерфейса.
06Как это помогает быстрее находить сбои
Главная ценность observability — связать разные данные между собой.
Например, мониторинг показывает, что количество ошибок выросло. Специалист открывает трассировку и видит проблемный сервис. Затем по trace_id находит связанные логи и получает подробную информацию об ошибке.
То есть вместо последовательной проверки десятков компонентов получается короткая цепочка:
обнаружили проблему → нашли проблемный сервис → увидели конкретную ошибку → определили причину.
Это особенно важно для микросервисов, Kubernetes и других сложных распределённых систем.
07Что такое AIOps
Следующий этап развития ИТ-мониторинга — AIOps, то есть применение искусственного интеллекта и автоматизированной аналитики для работы с большим количеством событий.
Современная инфраструктура может генерировать тысячи метрик, логов и уведомлений. Человеку сложно вручную анализировать весь этот объём.
AIOps может помогать:
- находить необычные изменения показателей;
- выявлять аномалии;
- объединять связанные события;
- уменьшать количество повторяющихся уведомлений;
- быстрее находить возможные причины инцидентов.
При этом AIOps не заменяет observability. Наоборот, качественные метрики, логи и трассировки становятся основой для автоматизированного анализа.
08Что важно учитывать при настройке мониторинга
Хороший ИТ-мониторинг — это не максимальное количество собранных данных. Важно собирать нужную информацию и правильно связывать её между собой.
Особое внимание стоит уделить передаче контекста между сервисами. Например, trace_id должен сохраняться при переходе запроса от одного компонента к другому. Тогда можно связать трассировку с соответствующими логами.
Для трассировок также используется sampling — выборочная запись запросов. Хранить данные абсолютно по каждому запросу может быть дорого, поэтому часть информации собирают выборочно, а для ошибок применяют отдельные правила.
Алерты обычно настраивают на основе метрик, а логи и трассировки используют для поиска причины.
09Польза observability для бизнеса
Внедрение современного ИТ-мониторинга даёт пользу не только техническим специалистам.
Для бизнеса это означает:
- меньше времени простоя сервисов;
- более быстрое устранение инцидентов;
- снижение риска потери клиентов из-за технических проблем;
- более стабильную работу цифровых сервисов;
- прозрачность состояния ИТ-инфраструктуры;
- меньше ручной работы для ИТ-команды.
Особенно заметна польза в компаниях, где ИТ-системы напрямую влияют на продажи, обслуживание клиентов или внутренние бизнес-процессы.
Современный ИТ-мониторинг постепенно превращается из простой системы уведомлений в полноценную систему наблюдаемости. Метрики показывают, что происходит, логи помогают понять, какая ошибка произошла, а трассировки позволяют определить, где именно возникла проблема.
Объединение этих данных с помощью observability помогает быстрее находить первопричины сбоев и сокращать время их устранения. А развитие AIOps позволяет автоматизировать часть анализа и справляться с растущим объёмом технических данных.
Для бизнеса итоговый эффект прост: ИТ-системы становятся более прозрачными и предсказуемыми, а проблемы обнаруживаются и устраняются быстрее.